Как я делал AI-агента для JiraMetrics.pro
Что стоит за надёжной работой агента: устройство инструментов, настройка поведения и систематические проверки.
Встроить работающего AI-агента в существующий продукт сегодня можно довольно быстро. Сложнее добиться того, чтобы пользователь мог доверить ему часть профессиональной работы. Для этого нужна системная настройка и проверка поведения агента: какие данные он выбирает, что считает, какие выводы делает и какие действия предлагает.
Даже небольшая правка формулировки в промпте, описания инструмента или состава контекста может повлиять на результат. Поэтому пользу изменения нужно проверять на одних и тех же пользовательских сценариях, с повторными запусками и разбором ответа целиком.
JiraMetrics.pro помогает анализировать, как задачи проходят через Jira: сколько времени занимает работа, где она накапливается, как меняется число завершённых задач. Расширение уже снимает часть рутины — собирает данные и строит отчёты. Но человеку всё ещё нужно просматривать графики, выбирать сопоставимые периоды и фильтры, сводить показатели и разбираться, что они означают для команды.
Мне хотелось отдать агенту часть этой работы. Пользователь задаёт вопрос в боковой панели, а агент выбирает отчёты, запрашивает данные и помогает их разобрать. Например, сравнивает время выполнения задач за два периода или смотрит, где накапливается незавершённая работа.
Разработку я начал ещё в 2025 году. К 2026 году я уже видел в агенте практическую пользу: часть разбора отчётов можно было поручить ему. Ниже — несколько решений из переработки агента в 2026 году: как устроены его инструменты, где проходят границы выводов и действий и на чём основано решение принять или отклонить изменение.
Инструменты агента описывает сам продукт
В расширении было девять отчётов и дашборд с виджетами. Сервер агента знал о четырёх отчётах. Их названия были записаны в моделях данных, особенности — в общем промпте, а для вызовов существовали отдельные функции на сервере.
Добавить отчёт в продукт было недостаточно: приходилось ещё описывать его в нескольких местах для агента. Так две части одного продукта постепенно расходились.
Источником описаний инструментов стало само расширение. В начале запроса оно передаёт серверу каталог: какие отчёты доступны, какие параметры они принимают и что возвращают. По этому каталогу модель выбирает инструмент. Сервер передаёт вызов в браузер, расширение выполняет его и возвращает результат.
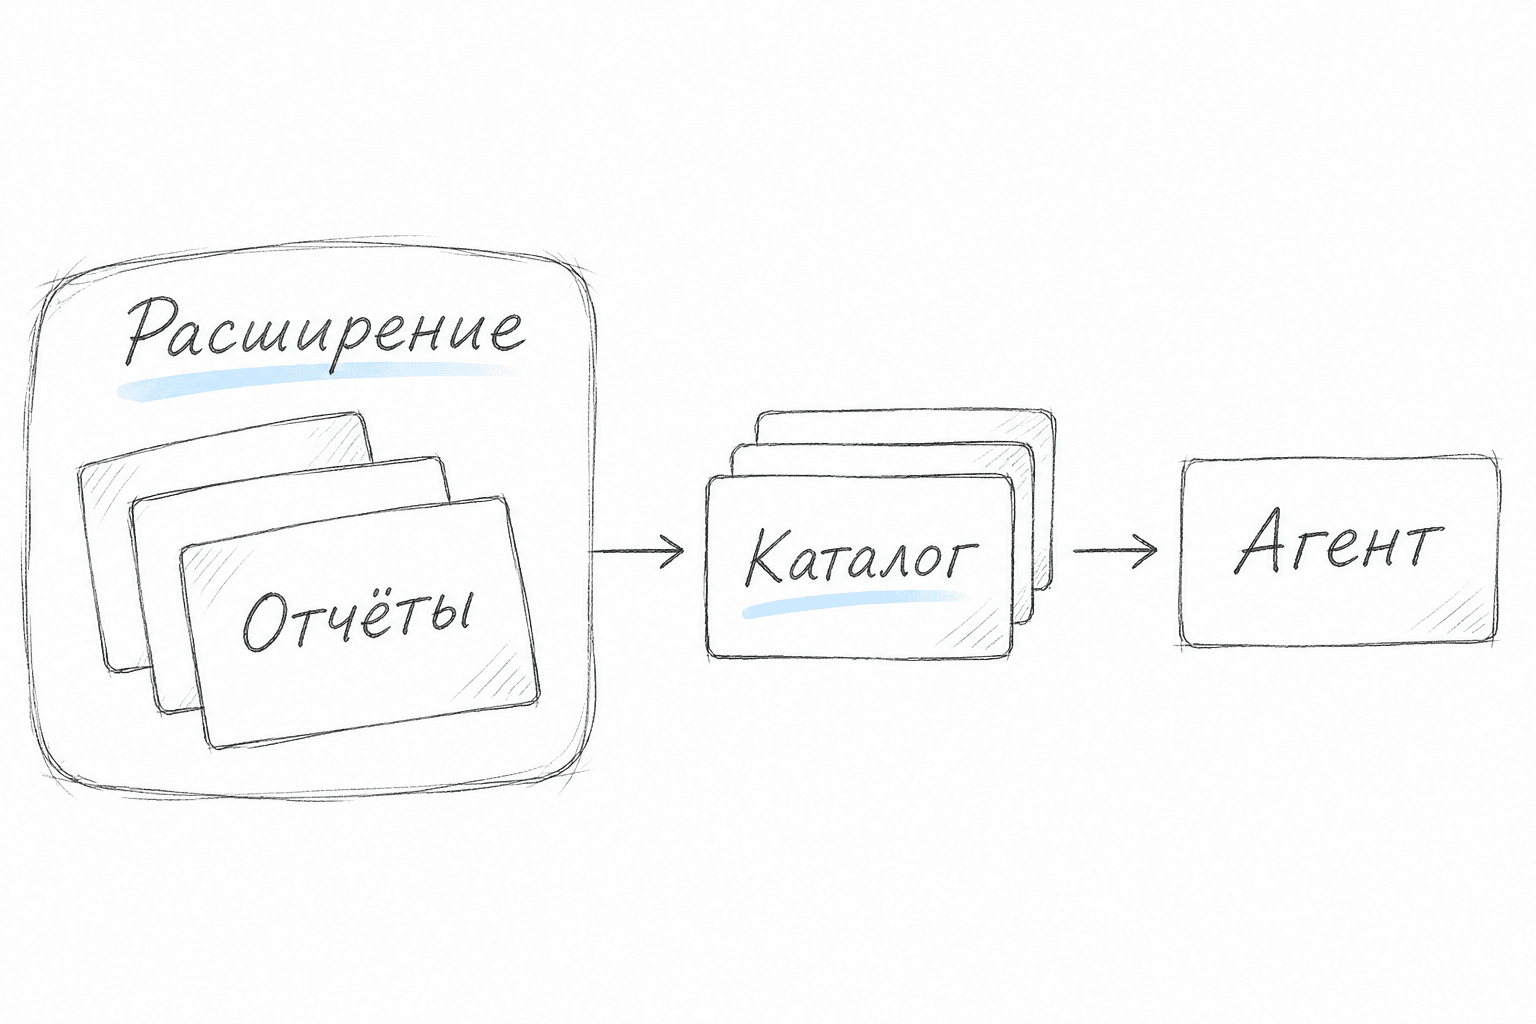
Для каждого отчёта я выбрал отдельный инструмент с собственной схемой параметров. Вариант с тремя общими функциями — найти отчёт, узнать его устройство, запросить данные — требовал бы дополнительных обращений за описаниями. Параметры запроса при этом становились слишком общими. Отдельная схема сразу задаёт модели допустимые поля и типы значений.
В модель для анализа передаются метрики движения задач, их ключи и параметры выборки — периоды, колонки и названия фильтров. Заголовков и описаний задач нет в данных самого расширения.
Агентный цикл работает на OpenAI Agents SDK. Для получения каталога и вызова инструментов я использовал его интерфейс MCPServer, а сообщения передаются по уже существовавшему WebSocket-соединению между браузером и сервером.
Расчёт остаётся в JiraMetrics.pro. Если агент запрашивает Lead Time — время прохождения задач через выбранные колонки, — работает тот же код, который строит график для пользователя. Так описание доступных отчётов и их расчёт оказались в одном месте, в расширении. Поддерживать для агента вторую реализацию метрик на сервере не пришлось.
Арифметика остаётся за кодом
Языковая модель генерирует текст, включая числа и формулы. Она способна решать арифметические задачи, но может подробно объяснить вычисление и ошибиться в результате. Для аналитического продукта полагаться на это нельзя: пользователь будет принимать решения по числу, которое увидит в чате.
Широкое правило «ничего не считай» мешало отвечать на обычные вопросы об итогах и разницах. Поэтому вычисления выполняет отдельный инструмент — небольшой калькулятор с разрешёнными операциями и десятичной арифметикой.
Модель выбирает операцию и исходные значения, код вычисляет сумму, разницу или процент изменения, а модель объясняет полученный результат пользователю.
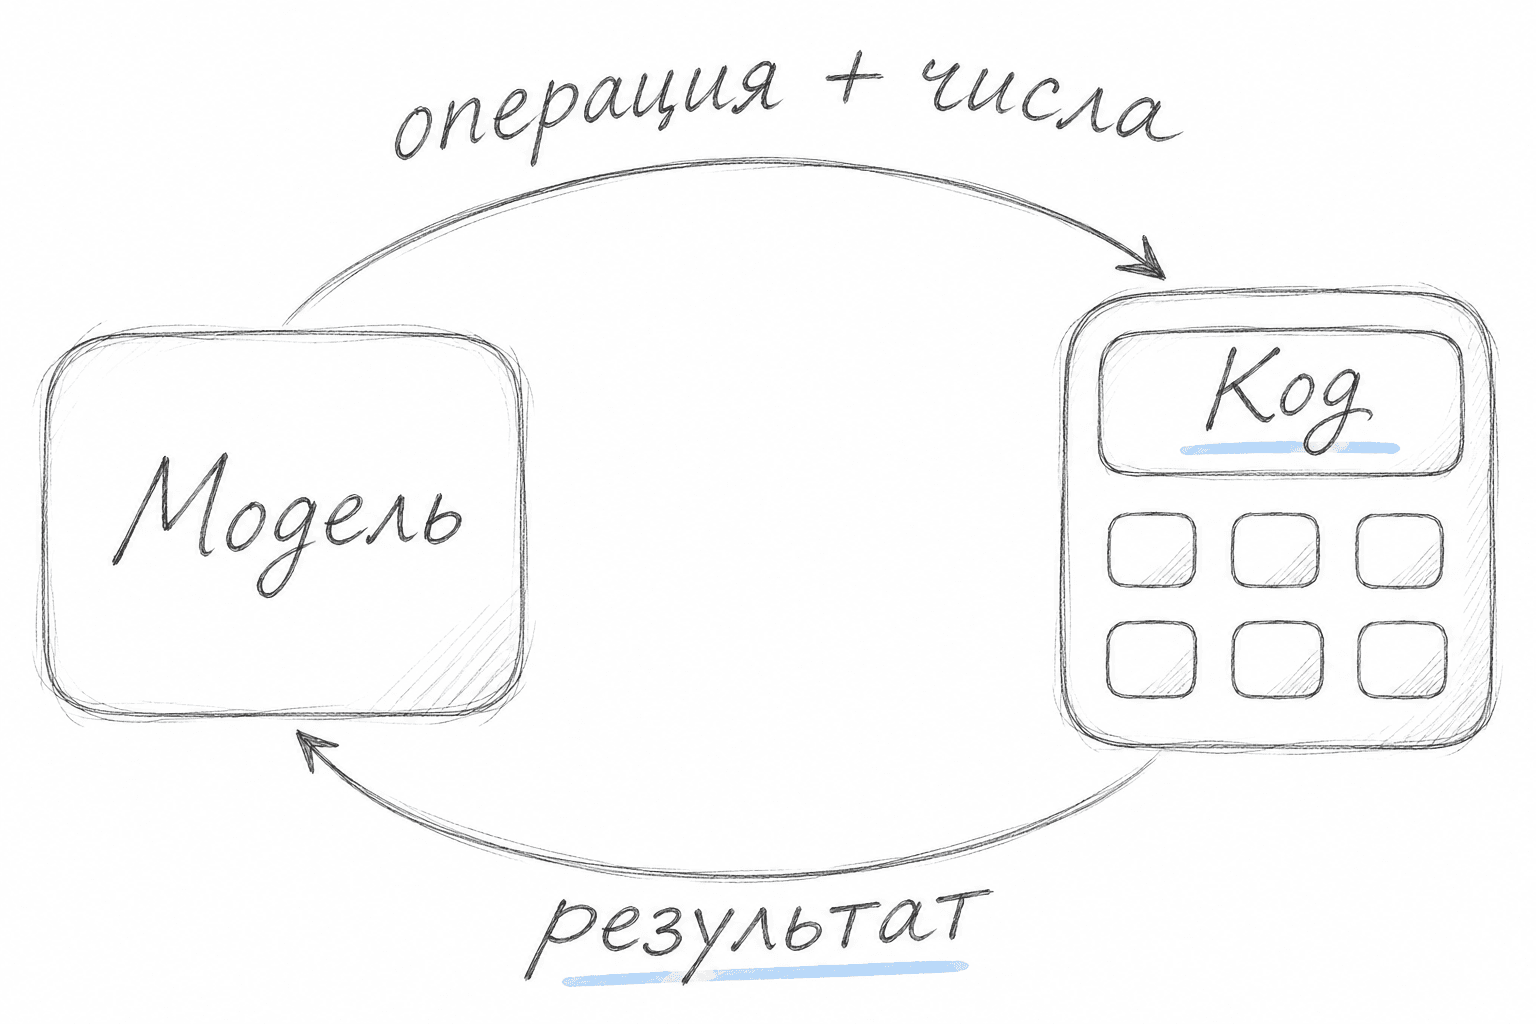
Калькулятор отвечает за вычисление, а выбор исходных данных остаётся за моделью. Она может взять показатели не за те периоды или потерять фильтр по типу задач. Поэтому проверка такого ответа включает и операцию, и исходные значения, и условия, при которых они получены.Правильная арифметика — только часть правильного ответа.
Какие выводы можно делать по метрике
«Когда эта задача дойдёт до следующей колонки?» — естественный вопрос человека, который ждёт результат работы. Он не обязан разбираться в статистике или знать, какие данные доступны агенту.
В моём случае агент мог получить возраст задачи и 85-й перцентиль — время, в которое уложились 85% задач исторической выборки. Дальше получалось внешне разумное действие: вычесть уже прошедшее время и назвать остаток.
Такое вычитание не даёт обоснованного прогноза. Перцентиль описывает полное время прохождения исторических задач, а вопрос об остатке относится к задачам, которые ещё не завершились к текущему возрасту. Вдобавок возраст в отчёте означал накопленное время в выбранных колонках и мог отличаться от времени в текущей колонке.
На истории сопоставимой работы можно построить ожидание уровня обслуживания в Kanban: срок прохождения задачи с определённой вероятностью. В той версии агента отдельного расчёта оставшегося времени не было. Полученные числа давали исторический ориентир, а модель превращала его в обещание срока.
Агент принимал предпосылку вопроса: будто доступных данных уже достаточно для расчёта срока. Это похоже на склонность моделей соглашаться с пользователем, хотя причину конкретной ошибки по этому случаю установить нельзя.
Одна замена модели проблему не устраняла. Иногда ошибка сохранялась даже в ответах с правильной оговоркой: агент писал, что прогноз дать нельзя, а затем всё равно приводил численный остаток. По одной формулировке отказа такой ответ можно было ошибочно принять за удачный.
В этих проверках помогло уточнение описания самого отчёта — там, где повторение правила в общем промпте не помогало. Описание указывало, что измерено, к каким колонкам относятся числа и для каких выводов они подходят. Ограничение на прогноз было связано с конкретной метрикой, которую агент собирался использовать.
Вместе с данными ему нужны границы их применения. В этом случае агент должен был объяснить положение задачи относительно прошлой работы и ограничения такой оценки. Оснований обещать дату завершения у него не было.
Кто решает, менять ли экран
На просьбу «покажешь мне?» агент иногда пытался изменить фильтры на экране, хотя человек мог ожидать ответ в чате.
Даже после уточнения инструкций такие попытки повторялись. Поэтому в разрабатываемой версии подтверждение изменений появилось в расширении, где исполняется действие. Если модель неверно понимала просьбу, пользователь всё равно мог отклонить предложенное изменение. Отказ возвращался агенту как результат вызова.
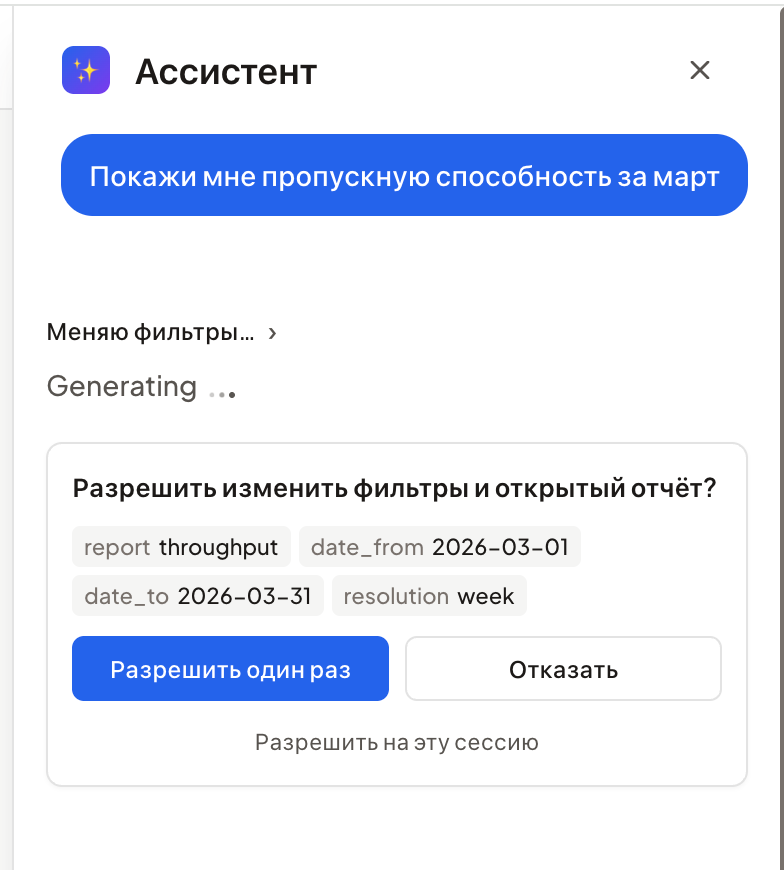
Для изменения экрана согласие проверялось на стороне исполнения. Модель могла предложить действие, а решение о его выполнении оставалось за пользователем.
Из ответа также можно было открыть отчёт с теми же фильтрами — например, по определённой команде за выбранный период. Это давало человеку возможность проверить анализ и продолжить работу самостоятельно.
Что считать улучшением агента
При сравнении вариантов важны два вопроса: стал ли агент лучше решать исходную задачу и сохранилось ли качество в других сценариях. Один из экспериментов с контекстом экрана хорошо показывает, почему эти вопросы нужно проверять вместе.
Пользователь уже выбрал на экране период, колонки и фильтры. Передать всё это вместе с вопросом казалось полезным: агент получил бы больше сведений о том, какие данные имеет в виду человек.
Сам инструмент отчёта уже умел брать неуказанные параметры с экрана и сообщать, какие фильтры применились. В эксперименте эти сведения дополнительно передавались самой модели — ещё до выбора инструмента. Каждый сценарий проверялся в двух сериях по пять запусков: со снимком экрана в контексте модели и без него.
В сценарии с Flow Efficiency — долей времени активной работы — со снимком экрана агент правильно запросил нужный срез данных во всех пяти запусках; без снимка — ни в одном из пяти. Содержательные ошибки в ответах сохранялись в обеих версиях. Например, пользователь заранее объяснил, что задачи ждут выпуска каждые две-три недели. В одном из ответов агент перечислил показатели ожидания, но не связал их с этим объяснением. Параметры экрана помогли получить отчёт; интерпретация всё ещё требовала учитывать сказанное в диалоге.
В другом сценарии пользователь спрашивал о конкретной задаче, которую скрывал выбранный на экране фильтр срочных задач. Для ответа требовалось запросить историю без этого ограничения. Без дополнительного контекста агент ошибочно сохранял фильтр в одном запуске из пяти. С дополнительным контекстом — в трёх запусках из пяти. Настройка экрана не подходила к новому вопросу, но продолжала определять выборку.
Правило о приоритете явно заданных пользователем условий уже было в промпте. Но в таком вопросе человек не перечисляет настройки, которые нужно переопределить: он просто называет задачу. Агенту ещё нужно определить, какие ограничения экрана несовместимы с этим запросом. Именно этот переход и требовал отдельной проверки.
Передачу снимка экрана я оставил выключенной. Проверки такого изменения должны охватывать и подходящие к вопросу настройки, и конфликтующие с ним. Правильный вызов инструмента показывает, какой этап улучшился; решение о включении изменения требует также проверить смысл ответа и отсутствие ухудшений в других сценариях.
Проверки развиваются вместе с агентом
Следующая версия агента может получить новые инструменты, другой контекст или другую модель. Для каждого такого изменения нужны основания считать, что пользовательские задачи по-прежнему решаются корректно. Набор проверок приходится поддерживать вместе с самим агентом.
Отдельный вопрос — память между сообщениями. В разрабатываемой версии в истории оставались реплики диалога, но не результаты инструментов. Следующий ответ мог опираться на уже написанный текст, потеряв исходные фильтры или размер выборки. Для продолжения анализа нужна связь выводов с периодом, фильтрами и исходными числами — и сценарии, которые проверяют её сохранение на протяжении диалога.
Такой подход я считаю основанием доверять агенту: понятная роль инструментов, обоснованные выводы, контроль действий и проверка изменений до их включения. Это работа, которая продолжается вместе с развитием продукта.
В следующей статье расскажу, как я тестирую этого агента: превращаю случаи из диалогов в проверки, сравниваю версии и разбираю ответы, которые автоматическая оценка сочла удачными. Если вам интересно, как я проверяю качество агента перед релизом, следите за продолжением.
Anvar Khakimov — Продакт и инженерный лид, 15+ лет пути от разработчика до руководителя. Делаю JMP, пишу о технологиях, менеджменте и AI.